Projet d'école · Data et IA · Projet réalisé
Segmentation de données à grande échelle avec K-Means
Identifier des groupes et des structures dans un jeu de données volumineux
Projet de Data Science consacré à l'analyse et à la segmentation d'un jeu de données d'environ 200 000 observations à l'aide de méthodes d'apprentissage non supervisé. L'objectif était d'explorer la structure des données, d'identifier des groupes présentant des caractéristiques communes et d'évaluer la pertinence des segments obtenus à l'aide d'indicateurs adaptés.
- Statut
- Projet réalisé
Problème initial
Face à un volume important de données, il peut être difficile d'identifier directement les groupes, les similitudes et les structures qui s'y trouvent.
Ce projet s'intéresse à l'utilisation de l'apprentissage non supervisé pour faire émerger des profils à partir des variables disponibles, sans disposer préalablement d'étiquettes de classification.
L'enjeu technique consiste à préparer correctement les données, choisir une méthode de regroupement appropriée et évaluer la cohérence des segments obtenus.
Démarche et décisions
Le travail s'est articulé autour de plusieurs étapes :
- Exploration du jeu de données et analyse des distributions.
- Préparation des variables et traitement des données en vue de la modélisation.
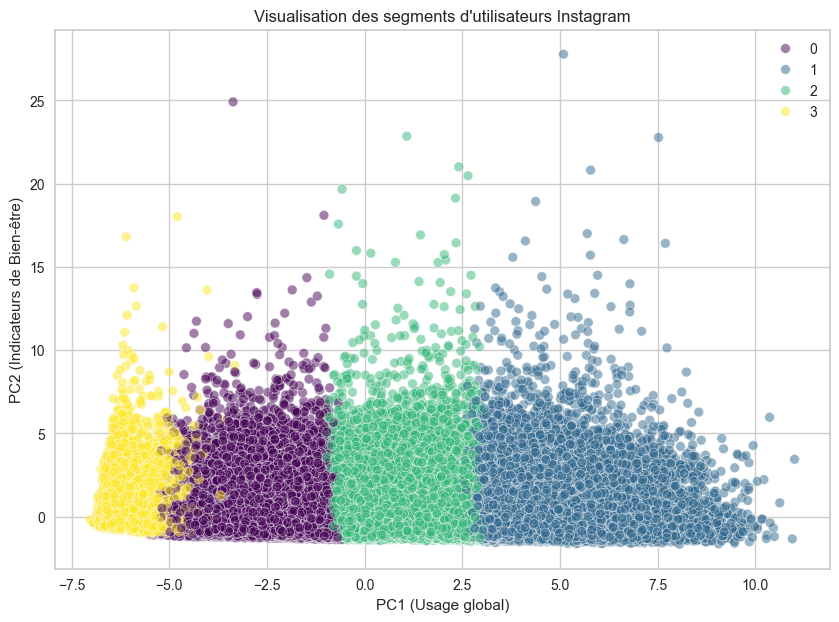
- Application de l'algorithme K-Means pour construire des groupes d'observations.
- Évaluation de la qualité du regroupement, notamment à l'aide du coefficient de silhouette.
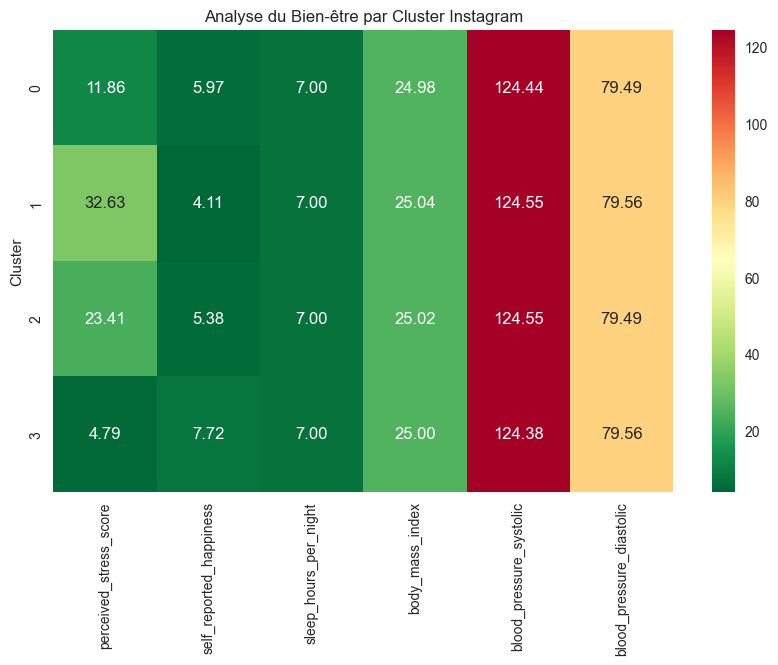
- Analyse et visualisation des groupes obtenus afin d'en faciliter l'interprétation.
Cette démarche m'a permis de mobiliser les différentes étapes d'un projet de machine learning non supervisé, de l'exploration des données à l'évaluation d'un modèle.
En images
Résultats
Le projet a permis d'expérimenter une méthode de segmentation non supervisée sur un jeu de données volumineux et d'étudier la cohérence des groupes obtenus.
L'évaluation s'est notamment appuyée sur le coefficient de silhouette, afin de comparer la séparation et la compacité des clusters.
L'analyse met en évidence l'importance de la préparation des variables, du choix des paramètres et de l'interprétation des résultats dans un problème de clustering.